智慧树知到《大数据工具应用》章节测试答案
智慧树知到《大数据工具应用》章节测试答案
第一章单元测试
1、2011年麦肯锡研究院提出的大数据定义是:大数据是指其大小超出了常规数据库工具获取、储存、管理和()能力的数据集。
A.计算
B.访问
C.应用
D.分析
正确答案:分析
2、用4V来概括大数据的特点的话,一般是指:Value、Velocity、Volume和()。
A.Variety
B.Vainly
C.Vagary
D.Valley
正确答案:Variety
3、大数据分析四个方面的工作主要是:数据分类、()、关联规则挖掘和时间序列预测。
A.数据统计
B.数据计算
C.数据聚类
D.数据清洗
正确答案:数据聚类
4、新浪和京东联合推出的大数据商品推荐,是由京东盲目推送到当前浏览新浪网站的用户的页面上的。
A.正确
B.错误
正确答案:B
5、目前的大数据处理技术只能处理结构化数据。
A.正确
B.错误
正确答案:B
6、2011年麦肯锡研究院提出的大数据定义是:大数据是指其大小超出了常规数据库工具获取、储存、管理和()能力的数据集。
A.计算
B.访问
C.应用
D.分析
正确答案:分析
7、用4V来概括大数据的特点的话,一般是指:Value、Velocity、Volume和()。
A.Variety
B.Vainly
C.Vagary
D.Valley
正确答案:Variety
8、大数据分析四个方面的工作主要是:数据分类、()、关联规则挖掘和时间序列预测。
A.数据统计
B.数据计算
C.数据聚类
D.数据清洗
正确答案:数据聚类
9、新浪和京东联合推出的大数据商品推荐,是由京东盲目推送到当前浏览新浪网站的用户的页面上的。
A.正确
B.错误
正确答案:B
10、目前的大数据处理技术只能处理结构化数据。
A.正确
B.错误
正确答案:B
11、2011年麦肯锡研究院提出的大数据定义是:大数据是指其大小超出了常规数据库工具获取、储存、管理和()能力的数据集。
A.计算
B.访问
C.应用
D.分析
正确答案:分析
12、用4V来概括大数据的特点的话,一般是指:Value、Velocity、Volume和()。
A.Variety
B.Vainly
C.Vagary
D.Valley
正确答案:Variety
13、大数据分析四个方面的工作主要是:数据分类、()、关联规则挖掘和时间序列预测。
A.数据统计
B.数据计算
C.数据聚类
D.数据清洗
正确答案:数据聚类
14、新浪和京东联合推出的大数据商品推荐,是由京东盲目推送到当前浏览新浪网站的用户的页面上的。
A.正确
B.错误
正确答案:B
15、目前的大数据处理技术只能处理结构化数据。
A.正确
B.错误
正确答案:B
第二章单元测试
1、我们常用的微软Office套件中的Access数据库软件的数据库文件格式后缀名是()。
A.mdf
B.mdb
C.dbf
D.xls
正确答案:mdb
2、大多数日志文件的后缀名是()。
A.txt
B.csv
C.xml
D.log
正确答案:log
3、本课程重点介绍的weka软件的专有文件格式是()。
A.MongoDB
B.ARFF
C.value
D.key map
正确答案:ARFF
4、数据清洗工作的目的主要是要解决数据的完整性、唯一性、合法性和()。
A.专业性
B.排他性
C.一致性
D.共享性
正确答案:一致性
5、八爪鱼软件的“自定义采集”工作方式下,需要在软件里输入一个()来作为采集的目标。
A.电话号码
B.关键词
C.网页地址
D.用户名
正确答案:网页地址
6、八爪鱼软件的采集规则可以通过文件的形式来导入或者导出,这种文件的后缀名是()。
A.otd
B.jpg
C.png
D.gif
正确答案:otd
7、Excel可以通过“数据有效性”按钮操作来规范数据输入的范围。
A.正确
B.错误
正确答案:A
8、Excel不能导入txt或csv格式的文件。
A.正确
B.错误
正确答案:B
9、八爪鱼软件只能对软件内建了“简易采集”规则的网站采集数据。
A.正确
B.错误
正确答案:B
10、八爪鱼软件进行自定义采集时,需要了解对网页的页面结构。
A.正确
B.错误
正确答案:A
11、我们常用的微软Office套件中的Access数据库软件的数据库文件格式后缀名是()。
A.mdf
B.mdb
C.dbf
D.xls
正确答案:mdb
12、大多数日志文件的后缀名是()。
A.txt
B.csv
C.xml
D.log
正确答案:log
13、本课程重点介绍的weka软件的专有文件格式是()。
A.MongoDB
B.ARFF
C.value
D.key map
正确答案:ARFF
14、数据清洗工作的目的主要是要解决数据的完整性、唯一性、合法性和()。
A.专业性
B.排他性
C.一致性
D.共享性
正确答案:一致性
15、八爪鱼软件的“自定义采集”工作方式下,需要在软件里输入一个()来作为采集的目标。
A.电话号码
B.关键词
C.网页地址
D.用户名
正确答案:网页地址
16、八爪鱼软件的采集规则可以通过文件的形式来导入或者导出,这种文件的后缀名是()。
A.otd
B.jpg
C.png
D.gif
正确答案:otd
17、Excel可以通过“数据有效性”按钮操作来规范数据输入的范围。
A.正确
B.错误
正确答案:A
18、Excel不能导入txt或csv格式的文件。
A.正确
B.错误
正确答案:B
19、八爪鱼软件只能对软件内建了“简易采集”规则的网站采集数据。
A.正确
B.错误
正确答案:B
20、八爪鱼软件进行自定义采集时,需要了解对网页的页面结构。
A.正确
B.错误
正确答案:A
21、我们常用的微软Office套件中的Access数据库软件的数据库文件格式后缀名是()。
A.mdf
B.mdb
C.dbf
D.xls
正确答案:mdb
22、大多数日志文件的后缀名是()。
A.txt
B.csv
C.xml
D.log
正确答案:log
23、本课程重点介绍的weka软件的专有文件格式是()。
A.MongoDB
B.ARFF
C.value
D.key map
正确答案:ARFF
24、数据清洗工作的目的主要是要解决数据的完整性、唯一性、合法性和()。
A.专业性
B.排他性
C.一致性
D.共享性
正确答案:一致性
25、八爪鱼软件的“自定义采集”工作方式下,需要在软件里输入一个()来作为采集的目标。
A.电话号码
B.关键词
C.网页地址
D.用户名
正确答案:网页地址
26、八爪鱼软件的采集规则可以通过文件的形式来导入或者导出,这种文件的后缀名是()。
A.otd
B.jpg
C.png
D.gif
正确答案:otd
27、Excel可以通过“数据有效性”按钮操作来规范数据输入的范围。
A.正确
B.错误
正确答案:A
28、Excel不能导入txt或csv格式的文件。
A.正确
B.错误
正确答案:B
29、八爪鱼软件只能对软件内建了“简易采集”规则的网站采集数据。
A.正确
B.错误
正确答案:B
30、八爪鱼软件进行自定义采集时,需要了解对网页的页面结构。
A.正确
B.错误
正确答案:A
第三章单元测试
1、使用DBSCAN算法对鸢尾花数据集(Iris.arff)进行聚类,将epsilon参数设置为0.2, minPoints参数设置为5,忽略class属性,那么将形成()个簇。
A.1
B.2
C.3
D.4
正确答案:3
2、使用EM算法对天气数据集(weather.numeric.arff)进行聚类,将numClusters设置为4,即簇数为4,其他参数保持默认值,忽略class属性,从结果中可知,下列选项中,()是错误的。
A.模型的最大似然估计值是-7.18
B.这组数据用算法迭代15次
C.第四个簇的先验概率是0.14
D.第四个簇的实例数为4
正确答案:第四个簇的实例数为4
3、使用SimpleKMeans算法对天气数据集(weather.numeric.arff)进行聚类,保持默认参数,即3个簇以及欧氏距离。选择play属性为忽略属性,从结果中可知,下列选项中,()是错误。
A.这组数据用算法迭代四次
B.产生了三个中心点
C.聚合为3个簇,分别有7,3,4个实例
D.平方和误差为8.928
正确答案:这组数据用算法迭代四次
4、使用线性回归(LinearRegression)分类器和用M5P分类器对cpu.arff分别进行分类,由其输出的误差指标可知()。
A.LinearRegression的标准误差比M5P的标准误差小
B.LinearRegression的平均绝对误差比M5P的平均绝对误差小
C.LinearRegression的相对误差比M5P的相对误差小
D.LinearRegression的平均方根误差比M5P的平均方根误差大
正确答案:LinearRegression的平均方根误差比M5P的平均方根误差大
5、删去cpu.arff数据文件中的CACH属性后,使用M5P分类器构建方案,在结果中,到达LM2的实例数有()个。
A.165
B.21
C.23
D.30
正确答案:21
6、根据J48分类器训练weather.nominal.arff所生产的决策树,当outlook=sunny;temperature=cool;humidity =high;windy=TRUE时,分类的结果是()。
A.Yes
B.No
C.没有结果
D.无法分类
正确答案:No
7、根据J48分类器训练iris.arff所生产的决策树,当sepallength=4.4;sepalwidth=3.0;petallength=1.3;petalwidth=0.2时,分类的结果是()。
A.Iris-setosa
B.Iris-versicolor
C.Iris-virginica
D.无法分类
正确答案:Iris-setosa
8、关于Weka离散化说明正确的是()。
A.离散化是将数值属性转换为字符串型属性
B.有监督离散化有两种等宽和等频方法
C.等宽离散化是使实例分布均匀的
D.离散化包括无监督离散化和有监督离散化
正确答案:离散化包括无监督离散化和有监督离散化
9、以下()不是Weka的数据类型。
A.numeric
B.nominal
C.string
D.decimal
正确答案:decimal
10、关于Weka的文件类型描述错误的是()。
A.Weka可以打开文件格式有.arff、.csv、.xlsx
B.Weka处理的数据集类似于关系数据库横行实例,竖行属性
C.arff是ASCII文件,可以用Word等文本编辑器打开查看
D.@relation 定义数据集名称,@data之后呈现实例,每一行就是一个实例
正确答案:Weka可以打开文件格式有.arff、.csv、.xlsx
11、以下属于关联分析的是()。
A.CPU性能预测
B.购物篮分析
C.自动判断鸢尾花类别
D.股票趋势建模
正确答案:购物篮分析
12、大数据时代的到来,使我们无法人为地去发现数据中的奥妙,与此同时,我们更应该注重数据中的相关关系,而不是因果关系。其中,数据之间的相关关系可以通过以下()算法直接挖掘。
A.K-means
B.Bayes Network
C.C4.5
D.Apriori
正确答案:Apriori
13、某超市研究销售纪录数据后发现,买啤酒的人很大概率也会购买尿布,这种属于数据挖掘的()问题。
A.关联规则发现
B.聚类
C.分类
D.自然语言处理
正确答案:关联规则发现
14、在进行自动选择属性时,必须设立两个对象,其中确定使用什么方法为每个属性子集分配一个评估值的对象是下面的()。
A.搜索方法
B.属性评估器
C.元分类器
D.规则挖掘
正确答案:属性评估器
15、以下属于属性空间的搜索方法的是()。
A.GainRatioAttributeEval
B.BestFirst
C.PrincipalComponents
D.SymmetricalUncertAttributeEval
正确答案:BestFirst
16、在weka软件探索者界面中,利用Visualize标签页通过更改各个参数来进行数据集的可视化属性设置后,需要单击以下()按钮,所有更改才会生效。
A.Select Attribute
B.SubSample
C.Update
D.Fast scrolling
正确答案:Update
17、给定关联规则AB,意味着:若A发生,B也会发生。
A.正确
B.错误
正确答案:B
18、支持度是衡量关联规则重要性的一个指标。
A.正确
B.错误
正确答案:A
19、Ranker方法既可以用于单个属性评估器,又可以用于属性子集评估器。
A.正确
B.错误
正确答案:B
20、利用weka软件进行数据可视化时,用户可以选择类别属性对数据点着色,如果类别属性是标称型,则显示为彩色条。
A.正确
B.错误
正确答案:B
21、使用DBSCAN算法对鸢尾花数据集(Iris.arff)进行聚类,将epsilon参数设置为0.2, minPoints参数设置为5,忽略class属性,那么将形成()个簇。
A.1
B.2
C.3
D.4
正确答案:3
22、使用EM算法对天气数据集(weather.numeric.arff)进行聚类,将numClusters设置为4,即簇数为4,其他参数保持默认值,忽略class属性,从结果中可知,下列选项中,()是错误的。
A.模型的最大似然估计值是-7.18
B.这组数据用算法迭代15次
C.第四个簇的先验概率是0.14
D.第四个簇的实例数为4
正确答案:第四个簇的实例数为4
23、使用SimpleKMeans算法对天气数据集(weather.numeric.arff)进行聚类,保持默认参数,即3个簇以及欧氏距离。选择play属性为忽略属性,从结果中可知,下列选项中,()是错误。
A.这组数据用算法迭代四次
B.产生了三个中心点
C.聚合为3个簇,分别有7,3,4个实例
D.平方和误差为8.928
正确答案:这组数据用算法迭代四次
24、使用线性回归(LinearRegression)分类器和用M5P分类器对cpu.arff分别进行分类,由其输出的误差指标可知()。
A.LinearRegression的标准误差比M5P的标准误差小
B.LinearRegression的平均绝对误差比M5P的平均绝对误差小
C.LinearRegression的相对误差比M5P的相对误差小
D.LinearRegression的平均方根误差比M5P的平均方根误差大
正确答案:LinearRegression的平均方根误差比M5P的平均方根误差大
25、删去cpu.arff数据文件中的CACH属性后,使用M5P分类器构建方案,在结果中,到达LM2的实例数有()个。
A.165
B.21
C.23
D.30
正确答案:21
26、根据J48分类器训练weather.nominal.arff所生产的决策树,当outlook=sunny;temperature=cool;humidity =high;windy=TRUE时,分类的结果是()。
A.Yes
B.No
C.没有结果
D.无法分类
正确答案:No
27、根据J48分类器训练iris.arff所生产的决策树,当sepallength=4.4;sepalwidth=3.0;petallength=1.3;petalwidth=0.2时,分类的结果是()。
A.Iris-setosa
B.Iris-versicolor
C.Iris-virginica
D.无法分类
正确答案:Iris-setosa
28、关于Weka离散化说明正确的是()。
A.离散化是将数值属性转换为字符串型属性
B.有监督离散化有两种等宽和等频方法
C.等宽离散化是使实例分布均匀的
D.离散化包括无监督离散化和有监督离散化
正确答案:离散化包括无监督离散化和有监督离散化
29、以下()不是Weka的数据类型。
A.numeric
B.nominal
C.string
D.decimal
正确答案:decimal
30、关于Weka的文件类型描述错误的是()。
A.Weka可以打开文件格式有.arff、.csv、.xlsx
B.Weka处理的数据集类似于关系数据库横行实例,竖行属性
C.arff是ASCII文件,可以用Word等文本编辑器打开查看
D.@relation 定义数据集名称,@data之后呈现实例,每一行就是一个实例
正确答案:Weka可以打开文件格式有.arff、.csv、.xlsx
31、以下属于关联分析的是()。
A.CPU性能预测
B.购物篮分析
C.自动判断鸢尾花类别
D.股票趋势建模
正确答案:购物篮分析
32、大数据时代的到来,使我们无法人为地去发现数据中的奥妙,与此同时,我们更应该注重数据中的相关关系,而不是因果关系。其中,数据之间的相关关系可以通过以下()算法直接挖掘。
A.K-means
B.Bayes Network
C.C4.5
D.Apriori
正确答案:Apriori
33、某超市研究销售纪录数据后发现,买啤酒的人很大概率也会购买尿布,这种属于数据挖掘的()问题。
A.关联规则发现
B.聚类
C.分类
D.自然语言处理
正确答案:关联规则发现
34、在进行自动选择属性时,必须设立两个对象,其中确定使用什么方法为每个属性子集分配一个评估值的对象是下面的()。
A.搜索方法
B.属性评估器
C.元分类器
D.规则挖掘
正确答案:属性评估器
35、以下属于属性空间的搜索方法的是()。
A.GainRatioAttributeEval
B.BestFirst
C.PrincipalComponents
D.SymmetricalUncertAttributeEval
正确答案:BestFirst
36、在weka软件探索者界面中,利用Visualize标签页通过更改各个参数来进行数据集的可视化属性设置后,需要单击以下()按钮,所有更改才会生效。
A.Select Attribute
B.SubSample
C.Update
D.Fast scrolling
正确答案:Update
37、给定关联规则AB,意味着:若A发生,B也会发生。
A.正确
B.错误
正确答案:B
38、支持度是衡量关联规则重要性的一个指标。
A.正确
B.错误
正确答案:A
39、Ranker方法既可以用于单个属性评估器,又可以用于属性子集评估器。
A.正确
B.错误
正确答案:B
40、利用weka软件进行数据可视化时,用户可以选择类别属性对数据点着色,如果类别属性是标称型,则显示为彩色条。
A.正确
B.错误
正确答案:B
41、使用DBSCAN算法对鸢尾花数据集(Iris.arff)进行聚类,将epsilon参数设置为0.2, minPoints参数设置为5,忽略class属性,那么将形成()个簇。
A.1
B.2
C.3
D.4
正确答案:3
42、使用EM算法对天气数据集(weather.numeric.arff)进行聚类,将numClusters设置为4,即簇数为4,其他参数保持默认值,忽略class属性,从结果中可知,下列选项中,()是错误的。
A.模型的最大似然估计值是-7.18
B.这组数据用算法迭代15次
C.第四个簇的先验概率是0.14
D.第四个簇的实例数为4
正确答案:第四个簇的实例数为4
43、使用SimpleKMeans算法对天气数据集(weather.numeric.arff)进行聚类,保持默认参数,即3个簇以及欧氏距离。选择play属性为忽略属性,从结果中可知,下列选项中,()是错误。
A.这组数据用算法迭代四次
B.产生了三个中心点
C.聚合为3个簇,分别有7,3,4个实例
D.平方和误差为8.928
正确答案:这组数据用算法迭代四次
44、使用线性回归(LinearRegression)分类器和用M5P分类器对cpu.arff分别进行分类,由其输出的误差指标可知()。
A.LinearRegression的标准误差比M5P的标准误差小
B.LinearRegression的平均绝对误差比M5P的平均绝对误差小
C.LinearRegression的相对误差比M5P的相对误差小
D.LinearRegression的平均方根误差比M5P的平均方根误差大
正确答案:LinearRegression的平均方根误差比M5P的平均方根误差大
45、删去cpu.arff数据文件中的CACH属性后,使用M5P分类器构建方案,在结果中,到达LM2的实例数有()个。
A.165
B.21
C.23
D.30
正确答案:21
46、根据J48分类器训练weather.nominal.arff所生产的决策树,当outlook=sunny;temperature=cool;humidity =high;windy=TRUE时,分类的结果是()。
A.Yes
B.No
C.没有结果
D.无法分类
正确答案:No
47、根据J48分类器训练iris.arff所生产的决策树,当sepallength=4.4;sepalwidth=3.0;petallength=1.3;petalwidth=0.2时,分类的结果是()。
A.Iris-setosa
B.Iris-versicolor
C.Iris-virginica
D.无法分类
正确答案:Iris-setosa
48、关于Weka离散化说明正确的是()。
A.离散化是将数值属性转换为字符串型属性
B.有监督离散化有两种等宽和等频方法
C.等宽离散化是使实例分布均匀的
D.离散化包括无监督离散化和有监督离散化
正确答案:离散化包括无监督离散化和有监督离散化
49、以下()不是Weka的数据类型。
A.numeric
B.nominal
C.string
D.decimal
正确答案:decimal
50、关于Weka的文件类型描述错误的是()。
A.Weka可以打开文件格式有.arff、.csv、.xlsx
B.Weka处理的数据集类似于关系数据库横行实例,竖行属性
C.arff是ASCII文件,可以用Word等文本编辑器打开查看
D.@relation 定义数据集名称,@data之后呈现实例,每一行就是一个实例
正确答案:Weka可以打开文件格式有.arff、.csv、.xlsx
51、以下属于关联分析的是()。
A.CPU性能预测
B.购物篮分析
C.自动判断鸢尾花类别
D.股票趋势建模
正确答案:购物篮分析
52、大数据时代的到来,使我们无法人为地去发现数据中的奥妙,与此同时,我们更应该注重数据中的相关关系,而不是因果关系。其中,数据之间的相关关系可以通过以下()算法直接挖掘。
A.K-means
B.Bayes Network
C.C4.5
D.Apriori
正确答案:Apriori
53、某超市研究销售纪录数据后发现,买啤酒的人很大概率也会购买尿布,这种属于数据挖掘的()问题。
A.关联规则发现
B.聚类
C.分类
D.自然语言处理
正确答案:关联规则发现
54、在进行自动选择属性时,必须设立两个对象,其中确定使用什么方法为每个属性子集分配一个评估值的对象是下面的()。
A.搜索方法
B.属性评估器
C.元分类器
D.规则挖掘
正确答案:属性评估器
55、以下属于属性空间的搜索方法的是()。
A.GainRatioAttributeEval
B.BestFirst
C.PrincipalComponents
D.SymmetricalUncertAttributeEval
正确答案:BestFirst
56、在weka软件探索者界面中,利用Visualize标签页通过更改各个参数来进行数据集的可视化属性设置后,需要单击以下()按钮,所有更改才会生效。
A.Select Attribute
B.SubSample
C.Update
D.Fast scrolling
正确答案:Update
57、给定关联规则AB,意味着:若A发生,B也会发生。
A.正确
B.错误
正确答案:B
58、支持度是衡量关联规则重要性的一个指标。
A.正确
B.错误
正确答案:A
59、Ranker方法既可以用于单个属性评估器,又可以用于属性子集评估器。
A.正确
B.错误
正确答案:B
60、利用weka软件进行数据可视化时,用户可以选择类别属性对数据点着色,如果类别属性是标称型,则显示为彩色条。
A.正确
B.错误
正确答案:B
第四章单元测试
1、贝叶斯网络中的节点代表()。
A.变量
B.随机过程
C.随机变量
D.随机函数
正确答案:随机变量
2、贝叶斯网络中,节点需给出概率分布描述,对于离散型随机变量而言,可以用()的形式表示。
A.条件概率密度函数
B.正态分布
C.条件概率表
D.均匀分布
正确答案:条件概率表
3、贝叶斯网络中节点之间的边代表()。
A.随机关系
B.概率因果
C.组合关系
D.随机结果
正确答案:随机关系
4、贝叶斯网络保存的文件格式是()。
A.XML BIF
B.DOCX
C.TXT
D.XLS
正确答案:XML BIF
5、下面()不是反向传播神经网络的结构。
A.输入层
B.隐含层
C.计算层
D.输出层
正确答案:计算层
6、神经网络中的节点代表()。
A.激励变量
B.激励函数
C.随机变量
D.随机函数
正确答案:激励函数
7、下列()不是常见的激励函数。
A.线性函数
B.Sigmoid函数
C.阈值函数
D.正弦函数
正确答案:正弦函数
8、在贝叶斯网络编辑界面时,如果节点的名称没法完全显示,需要从()菜单项进行调整。
A.Tools|SetData
B.View|Zoom Out
C.View|Zoom In
D.Tools|Layout
正确答案:Tools|Layout
9、WEKA中选择神经网络分类器操作时,应该选择()。
A.rules条目下的PART
B.functions条目下的SGD分类器
C.functions条目下的MultilayerPerceptron分类器
D.默认的分类器
正确答案:functions条目下的MultilayerPerceptron分类器
10、下面关于Package Manager安装后的目录说明不正确的是()。
A.doc子目录存放API文档
B.lib子目录存放包所需要的说明文件
C.sample-data子目录存放数据集文件
D.src子目录存放源代码文件
正确答案:lib子目录存放包所需要的说明文件
11、贝叶斯网络中的节点代表()。
A.变量
B.随机过程
C.随机变量
D.随机函数
正确答案:随机变量
12、贝叶斯网络中,节点需给出概率分布描述,对于离散型随机变量而言,可以用()的形式表示。
A.条件概率密度函数
B.正态分布
C.条件概率表
D.均匀分布
正确答案:条件概率表
13、贝叶斯网络中节点之间的边代表()。
A.随机关系
B.概率因果
C.组合关系
D.随机结果
正确答案:随机关系
14、贝叶斯网络保存的文件格式是()。
A.XML BIF
B.DOCX
C.TXT
D.XLS
正确答案:XML BIF
15、下面()不是反向传播神经网络的结构。
A.输入层
B.隐含层
C.计算层
D.输出层
正确答案:计算层
16、神经网络中的节点代表()。
A.激励变量
B.激励函数
C.随机变量
D.随机函数
正确答案:激励函数
17、下列()不是常见的激励函数。
A.线性函数
B.Sigmoid函数
C.阈值函数
D.正弦函数
正确答案:正弦函数
18、在贝叶斯网络编辑界面时,如果节点的名称没法完全显示,需要从()菜单项进行调整。
A.Tools|SetData
B.View|Zoom Out
C.View|Zoom In
D.Tools|Layout
正确答案:Tools|Layout
19、WEKA中选择神经网络分类器操作时,应该选择()。
A.rules条目下的PART
B.functions条目下的SGD分类器
C.functions条目下的MultilayerPerceptron分类器
D.默认的分类器
正确答案:functions条目下的MultilayerPerceptron分类器
20、下面关于Package Manager安装后的目录说明不正确的是()。
A.doc子目录存放API文档
B.lib子目录存放包所需要的说明文件
C.sample-data子目录存放数据集文件
D.src子目录存放源代码文件
正确答案:lib子目录存放包所需要的说明文件
21、贝叶斯网络中的节点代表()。
A.变量
B.随机过程
C.随机变量
D.随机函数
正确答案:随机变量
22、贝叶斯网络中,节点需给出概率分布描述,对于离散型随机变量而言,可以用()的形式表示。
A.条件概率密度函数
B.正态分布
C.条件概率表
D.均匀分布
正确答案:条件概率表
23、贝叶斯网络中节点之间的边代表()。
A.随机关系
B.概率因果
C.组合关系
D.随机结果
正确答案:随机关系
24、贝叶斯网络保存的文件格式是()。
A.XML BIF
B.DOCX
C.TXT
D.XLS
正确答案:XML BIF
25、下面()不是反向传播神经网络的结构。
A.输入层
B.隐含层
C.计算层
D.输出层
正确答案:计算层
26、神经网络中的节点代表()。
A.激励变量
B.激励函数
C.随机变量
D.随机函数
正确答案:激励函数
27、下列()不是常见的激励函数。
A.线性函数
B.Sigmoid函数
C.阈值函数
D.正弦函数
正确答案:正弦函数
28、在贝叶斯网络编辑界面时,如果节点的名称没法完全显示,需要从()菜单项进行调整。
A.Tools|SetData
B.View|Zoom Out
C.View|Zoom In
D.Tools|Layout
正确答案:Tools|Layout
29、WEKA中选择神经网络分类器操作时,应该选择()。
A.rules条目下的PART
B.functions条目下的SGD分类器
C.functions条目下的MultilayerPerceptron分类器
D.默认的分类器
正确答案:functions条目下的MultilayerPerceptron分类器
30、下面关于Package Manager安装后的目录说明不正确的是()。
A.doc子目录存放API文档
B.lib子目录存放包所需要的说明文件
C.sample-data子目录存放数据集文件
D.src子目录存放源代码文件
正确答案:lib子目录存放包所需要的说明文件
第五章单元测试
1、Tableau是一款定位于数据可视化敏捷开发和实现()展现工具。Tableau 连续第 6 年在 Gartner 分析和商业智能魔力象限中蝉联领导者殊荣。
A.商务智能
B.商业行为
C.商务计算
D.商业统计
正确答案:商务智能
2、以下()不是Tableau的数据类型?
A.Boolean
B.Date
C.
String
D.Decimal
正确答案:Decimal
3、Tableau可以用来实现交互的、()的分析和仪表板应用,从而帮助我们快速地认识和理解数据。
A.
连续性
B.离散性
C.智能化
D.可视化
正确答案:可视化
4、下列说法错误的是()。
A.Tableau通过内存数据引擎,可以直接查询外部数据库同时动态的从数据仓库抽取实时数据,极大的提高了数据访问和查询效率
B.用户仅需要通过轻点鼠标和简单拖放就可以迅速创建出智能、精美、直观和具有强交互性的报表和仪表盘
C.Tableau允许从多个数据源访问数据,包括带分隔符的文本文件、Excel文件、SQL数据库、Oracle数据库和多维数据库等
D.Tableau不提供应用编程接口
正确答案:Tableau不提供应用编程接口
5、度量往往是()字段,度量是我们的指标。度量常常是连续的,连续的字段在图表中形成轴.将其拖放到功能区时,Tableau默认会进行()。
A.数值,聚合运算
B.数值,混合运算
C.分类,聚合运算
D.分类,混合运算
正确答案:数值,聚合运算
6、关于数据分层描述错误的是()。
A.数据分层可以实现向上钻取
B.数据分层可以实现向下钻取
C.数据分层的层级结构由数据维度的上下顺序决定
D.数据分层的层次结构可以手工调整
正确答案:数据分层可以实现向上钻取
7、以下不属于集的创建方式的是()。
A.[常规]创建
B.[条件]创建
C.[顶部]创建
D.[分组]创建
正确答案:[分组]创建
8、Tableau右边数据目录栏中,不能单击右键创建参数的纬度是()。
A.纬度
B.度量
C.集
D.参数
正确答案:集
9、以下不是创建计算字段时的运算逻辑的是()。
A.数字
B.日期
C.用户
D.表结构
正确答案:表结构
10、仪表板版面大小设计选项,()不属于大小设计选项。
A.固定大小
B.自动
C.范围
D.自定义
正确答案:自定义
11、Tableau是一款定位于数据可视化敏捷开发和实现()展现工具。Tableau 连续第 6 年在 Gartner 分析和商业智能魔力象限中蝉联领导者殊荣。
A.商务智能
B.商业行为
C.商务计算
D.商业统计
正确答案:商务智能
12、以下()不是Tableau的数据类型?
A.Boolean
B.Date
C.
String
D.Decimal
正确答案:Decimal
13、Tableau可以用来实现交互的、()的分析和仪表板应用,从而帮助我们快速地认识和理解数据。
A.
连续性
B.离散性
C.智能化
D.可视化
正确答案:可视化
14、下列说法错误的是()。
A.Tableau通过内存数据引擎,可以直接查询外部数据库同时动态的从数据仓库抽取实时数据,极大的提高了数据访问和查询效率
B.用户仅需要通过轻点鼠标和简单拖放就可以迅速创建出智能、精美、直观和具有强交互性的报表和仪表盘
C.Tableau允许从多个数据源访问数据,包括带分隔符的文本文件、Excel文件、SQL数据库、Oracle数据库和多维数据库等
D.Tableau不提供应用编程接口
正确答案:Tableau不提供应用编程接口
15、度量往往是()字段,度量是我们的指标。度量常常是连续的,连续的字段在图表中形成轴.将其拖放到功能区时,Tableau默认会进行()。
A.数值,聚合运算
B.数值,混合运算
C.分类,聚合运算
D.分类,混合运算
正确答案:数值,聚合运算
16、关于数据分层描述错误的是()。
A.数据分层可以实现向上钻取
B.数据分层可以实现向下钻取
C.数据分层的层级结构由数据维度的上下顺序决定
D.数据分层的层次结构可以手工调整
正确答案:数据分层可以实现向上钻取
17、以下不属于集的创建方式的是()。
A.[常规]创建
B.[条件]创建
C.[顶部]创建
D.[分组]创建
正确答案:[分组]创建
18、Tableau右边数据目录栏中,不能单击右键创建参数的纬度是()。
A.纬度
B.度量
C.集
D.参数
正确答案:集
19、以下不是创建计算字段时的运算逻辑的是()。
A.数字
B.日期
C.用户
D.表结构
正确答案:表结构
20、仪表板版面大小设计选项,()不属于大小设计选项。
A.固定大小
B.自动
C.范围
D.自定义
正确答案:自定义
21、Tableau是一款定位于数据可视化敏捷开发和实现()展现工具。Tableau 连续第 6 年在 Gartner 分析和商业智能魔力象限中蝉联领导者殊荣。
A.商务智能
B.商业行为
C.商务计算
D.商业统计
正确答案:商务智能
22、以下()不是Tableau的数据类型?
A.Boolean
B.Date
C.
String
D.Decimal
正确答案:Decimal
23、Tableau可以用来实现交互的、()的分析和仪表板应用,从而帮助我们快速地认识和理解数据。
A.
连续性
B.离散性
C.智能化
D.可视化
正确答案:可视化
24、下列说法错误的是()。
A.Tableau通过内存数据引擎,可以直接查询外部数据库同时动态的从数据仓库抽取实时数据,极大的提高了数据访问和查询效率
B.用户仅需要通过轻点鼠标和简单拖放就可以迅速创建出智能、精美、直观和具有强交互性的报表和仪表盘
C.Tableau允许从多个数据源访问数据,包括带分隔符的文本文件、Excel文件、SQL数据库、Oracle数据库和多维数据库等
D.Tableau不提供应用编程接口
正确答案:Tableau不提供应用编程接口
25、度量往往是()字段,度量是我们的指标。度量常常是连续的,连续的字段在图表中形成轴.将其拖放到功能区时,Tableau默认会进行()。
A.数值,聚合运算
B.数值,混合运算
C.分类,聚合运算
D.分类,混合运算
正确答案:数值,聚合运算
26、关于数据分层描述错误的是()。
A.数据分层可以实现向上钻取
B.数据分层可以实现向下钻取
C.数据分层的层级结构由数据维度的上下顺序决定
D.数据分层的层次结构可以手工调整
正确答案:数据分层可以实现向上钻取
27、以下不属于集的创建方式的是()。
A.[常规]创建
B.[条件]创建
C.[顶部]创建
D.[分组]创建
正确答案:[分组]创建
28、Tableau右边数据目录栏中,不能单击右键创建参数的纬度是()。
A.纬度
B.度量
C.集
D.参数
正确答案:集
29、以下不是创建计算字段时的运算逻辑的是()。
A.数字
B.日期
C.用户
D.表结构
正确答案:表结构
30、仪表板版面大小设计选项,()不属于大小设计选项。
A.固定大小
B.自动
C.范围
D.自定义
正确答案:自定义
第六章单元测试
1、Logistic函数的定义域是()。
A.(-INF, +INF)
B.[0, 1]
C.(0, +INF)
D.(-INF, 1)
正确答案:(-INF, +INF)
2、下列叙述错误的是()。
A.逻辑回归是一种监督机器学习算法
B.逻辑回归主要用于回归分析
C.逻辑回归采用Sigmoid函数对样本数据进行拟合,以构建回归模型
D.逻辑回归预测事件发生的概率并分析导致事件发生的因素
正确答案:逻辑回归主要用于回归分析
3、使用IBk分类器和SMO分类器对vote.arff分别进行分类,由其输出的结果可知()。
A.IBk正确分类百分比比SMO大
B.IBk对republican的分类正确率比SMO大
C.SMO对democrat的分类正确率比IBk小
D.SMO对democrat和republican的分类正确率都比IBk大
正确答案:SMO对democrat和republican的分类正确率都比IBk大
4、
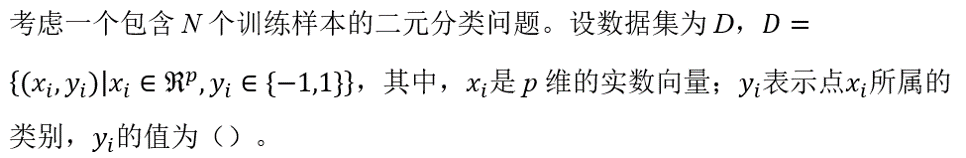
A.0或1
B.0或-1
C.1或-1
D.true或false
正确答案:1或-1
5、以下描述错误的是()。
A.SVM对噪声不具备鲁棒性
B.SVM寻找具有最小边缘的超平面,因此经常被称为最小边缘分类器
C.k-最近邻算法(K-NN)是一种消极学习器
D.聚类分析可以看作是一种非监督的分类
正确答案:SVM寻找具有最小边缘的超平面,因此经常被称为最小边缘分类器
6、线性支持向量机的最大化间隔正确的描述是()。
A.
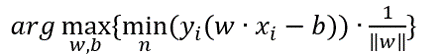
B.
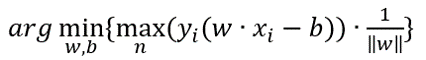
C.
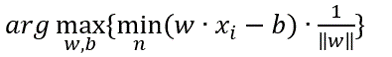
D.
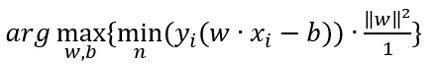
正确答案:
7、以下计算距离的公式中,计算欧氏距离的是()。
A.
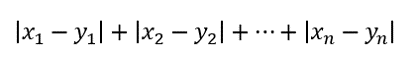
B.
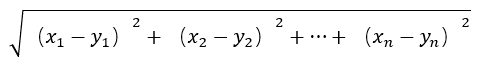
C.
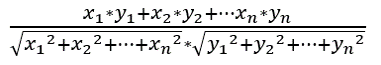
D.
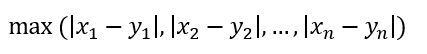
正确答案:
8、Logistic函数的定义域是()。
A.(-INF, +INF)
B.[0, 1]
C.(0, +INF)
D.(-INF, 1)
正确答案:(-INF, +INF)
9、下列叙述错误的是()。
A.逻辑回归是一种监督机器学习算法
B.逻辑回归主要用于回归分析
C.逻辑回归采用Sigmoid函数对样本数据进行拟合,以构建回归模型
D.逻辑回归预测事件发生的概率并分析导致事件发生的因素
正确答案:逻辑回归主要用于回归分析
10、使用IBk分类器和SMO分类器对vote.arff分别进行分类,由其输出的结果可知()。
A.IBk正确分类百分比比SMO大
B.IBk对republican的分类正确率比SMO大
C.SMO对democrat的分类正确率比IBk小
D.SMO对democrat和republican的分类正确率都比IBk大
正确答案:SMO对democrat和republican的分类正确率都比IBk大
11、
A.0或1
B.0或-1
C.1或-1
D.true或false
正确答案:1或-1
12、以下描述错误的是()。
A.SVM对噪声不具备鲁棒性
B.SVM寻找具有最小边缘的超平面,因此经常被称为最小边缘分类器
C.k-最近邻算法(K-NN)是一种消极学习器
D.聚类分析可以看作是一种非监督的分类
正确答案:SVM寻找具有最小边缘的超平面,因此经常被称为最小边缘分类器
13、线性支持向量机的最大化间隔正确的描述是()。
A.
B.
C.
D.
正确答案:
14、以下计算距离的公式中,计算欧氏距离的是()。
A.
B.
C.
D.
正确答案:
15、Logistic函数的定义域是()。
A.(-INF, +INF)
B.[0, 1]
C.(0, +INF)
D.(-INF, 1)
正确答案:(-INF, +INF)
16、下列叙述错误的是()。
A.逻辑回归是一种监督机器学习算法
B.逻辑回归主要用于回归分析
C.逻辑回归采用Sigmoid函数对样本数据进行拟合,以构建回归模型
D.逻辑回归预测事件发生的概率并分析导致事件发生的因素
正确答案:逻辑回归主要用于回归分析
17、使用IBk分类器和SMO分类器对vote.arff分别进行分类,由其输出的结果可知()。
A.IBk正确分类百分比比SMO大
B.IBk对republican的分类正确率比SMO大
C.SMO对democrat的分类正确率比IBk小
D.SMO对democrat和republican的分类正确率都比IBk大
正确答案:SMO对democrat和republican的分类正确率都比IBk大
18、
A.0或1
B.0或-1
C.1或-1
D.true或false
正确答案:1或-1
19、以下描述错误的是()。
A.SVM对噪声不具备鲁棒性
B.SVM寻找具有最小边缘的超平面,因此经常被称为最小边缘分类器
C.k-最近邻算法(K-NN)是一种消极学习器
D.聚类分析可以看作是一种非监督的分类
正确答案:SVM寻找具有最小边缘的超平面,因此经常被称为最小边缘分类器
20、线性支持向量机的最大化间隔正确的描述是()。
A.
B.
C.
D.
正确答案:
21、以下计算距离的公式中,计算欧氏距离的是()。
A.
B.
C.
D.
正确答案:
第七章单元测试
1、以下数据和信息的说法,不正确的是()。
A.信息是客观世界各种事物特征的反映
B.数据对用户来说是有价值的
C.数据的形式是多样化的
D.凡是可以电子化记录下来的都是数据
正确答案:数据对用户来说是有价值的
2、以下关于数据分析的方法,正确的是()。
A.数据分析是信息到数据的转换过程
B.分析是一个过程,分析的对象是信息
C.所有的分析都是要从“过程”出发,没有结论的数字罗列并不是分析
D.数据分析的目的就是解决我们现实中的某个问题
正确答案:数据分析的目的就是解决我们现实中的某个问题
3、以下不属于数据分析的作用的是()。
A.数据分析有助于增加营销开支
B.数据分析有助于企业分析目标客户
C.数据分析有助于企业绩效分析与管理
D.数据分析有助于优化运营前线
正确答案:数据分析有助于增加营销开支
4、以下不属于问题的有效性检验的是()。
A.复杂性检验
B.必要性检验
C.有用性检验
D.可行性检验
正确答案:必要性检验
5、图a到图b的转变,属于数据分析思维中的哪一种思维()。图a
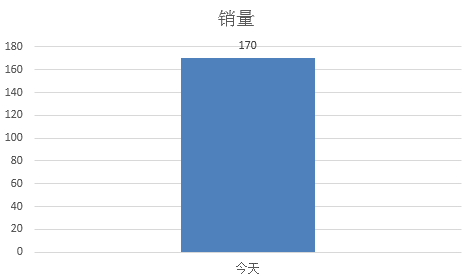
图b
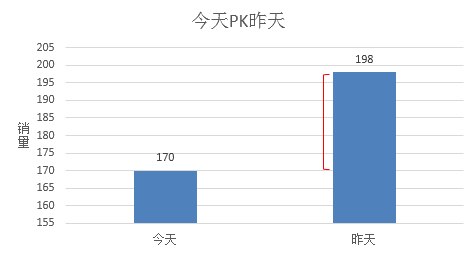
A.对照
B.拆分
C.降维
D.增维
正确答案:对照
6、当我们当前的维度不能很好地解释我们的问题时,我们就需要对数据做一个运算,增加多一个指标。这属于以下哪种思维方式()。
A.对照
B.拆分
C.降维
D.增维
正确答案:增维
7、对()的理解是数据分析的前提。
A.数据
B.信息
C.业务
D.结果
正确答案:业务
8、以下不属于初级数据分析方法的是()。
A.回归分析法
B.平均分析法
C.对比分析法
D.交叉分析法
正确答案:回归分析法
9、对多种影响因素按其重要程度进行一定组合,先按第一组合选择出较大范围目标对象,再按第二组合对第一组合筛选出来的对象进一步缩小范围,以此类推,得出最终目标对象。该描述是以下哪种数据分析方法的思想()。
A.回归分析法
B.平均分析法
C.对比分析法
D.层层筛选法
正确答案:层层筛选法
10、一个好的统计图需满足的标准,不包括以下()。
A.准确
B.有效
C.简洁
D.清楚
正确答案:清楚
11、一般情况下在作图时先不添加()区。
A.坐标轴
B.绘图区
C.标题区
D.图例区
正确答案:标题区
12、连续性单变量图不包括()。
A.直方图
B.箱线图
C.P-P图
D.条形图
正确答案:条形图
13、两个定性变量可选择的作图不包括()。
A.复式条形图
B.散点图
C.堆叠条形图
D.马赛克图
正确答案:散点图
14、堆叠条形图和马赛克图可以在图形属性中直接转换。
A.正确
B.错误
正确答案:A
15、定性变量作定量变量的相应图形也是有意义的。
A.正确
B.错误
正确答案:B
16、多维度数据图形一般还是以二维的形式展示,只通过形状、颜色等要素扩展维度信息。
A.正确
B.错误
正确答案:A
17、制作统计图有两个基本要求:一是正确,二是简洁。
A.正确
B.错误
正确答案:A
18、一般情况下在作图时先不添加()区。
A.坐标轴
B.绘图区
C.标题区
D.图例区
正确答案:标题区
19、连续性单变量图不包括()。
A.直方图
B.箱线图
C.P-P图
D.条形图
正确答案:条形图
20、两个定性变量可选择的作图不包括()。
A.复式条形图
B.散点图
C.堆叠条形图
D.马赛克图
正确答案:散点图
21、堆叠条形图和马赛克图可以在图形属性中直接转换。
A.正确
B.错误
正确答案:A
22、定性变量作定量变量的相应图形也是有意义的。
A.正确
B.错误
正确答案:B
23、多维度数据图形一般还是以二维的形式展示,只通过形状、颜色等要素扩展维度信息。
A.正确
B.错误
正确答案:A
24、制作统计图有两个基本要求:一是正确,二是简洁。
A.正确
B.错误
正确答案:A
第一章单元测试
1、2011年麦肯锡研究院提出的大数据定义是:大数据是指其大小超出了常规数据库工具获取、储存、管理和()能力的数据集。
A.计算
B.访问
C.应用
D.分析
正确答案:分析
2、用4V来概括大数据的特点的话,一般是指:Value、Velocity、Volume和()。
A.Variety
B.Vainly
C.Vagary
D.Valley
正确答案:Variety
3、大数据分析四个方面的工作主要是:数据分类、()、关联规则挖掘和时间序列预测。
A.数据统计
B.数据计算
C.数据聚类
D.数据清洗
正确答案:数据聚类
4、新浪和京东联合推出的大数据商品推荐,是由京东盲目推送到当前浏览新浪网站的用户的页面上的。
A.正确
B.错误
正确答案:B
5、目前的大数据处理技术只能处理结构化数据。
A.正确
B.错误
正确答案:B
6、2011年麦肯锡研究院提出的大数据定义是:大数据是指其大小超出了常规数据库工具获取、储存、管理和()能力的数据集。
A.计算
B.访问
C.应用
D.分析
正确答案:分析
7、用4V来概括大数据的特点的话,一般是指:Value、Velocity、Volume和()。
A.Variety
B.Vainly
C.Vagary
D.Valley
正确答案:Variety
8、大数据分析四个方面的工作主要是:数据分类、()、关联规则挖掘和时间序列预测。
A.数据统计
B.数据计算
C.数据聚类
D.数据清洗
正确答案:数据聚类
9、新浪和京东联合推出的大数据商品推荐,是由京东盲目推送到当前浏览新浪网站的用户的页面上的。
A.正确
B.错误
正确答案:B
10、目前的大数据处理技术只能处理结构化数据。
A.正确
B.错误
正确答案:B
11、2011年麦肯锡研究院提出的大数据定义是:大数据是指其大小超出了常规数据库工具获取、储存、管理和()能力的数据集。
A.计算
B.访问
C.应用
D.分析
正确答案:分析
12、用4V来概括大数据的特点的话,一般是指:Value、Velocity、Volume和()。
A.Variety
B.Vainly
C.Vagary
D.Valley
正确答案:Variety
13、大数据分析四个方面的工作主要是:数据分类、()、关联规则挖掘和时间序列预测。
A.数据统计
B.数据计算
C.数据聚类
D.数据清洗
正确答案:数据聚类
14、新浪和京东联合推出的大数据商品推荐,是由京东盲目推送到当前浏览新浪网站的用户的页面上的。
A.正确
B.错误
正确答案:B
15、目前的大数据处理技术只能处理结构化数据。
A.正确
B.错误
正确答案:B
第二章单元测试
1、我们常用的微软Office套件中的Access数据库软件的数据库文件格式后缀名是()。
A.mdf
B.mdb
C.dbf
D.xls
正确答案:mdb
2、大多数日志文件的后缀名是()。
A.txt
B.csv
C.xml
D.log
正确答案:log
3、本课程重点介绍的weka软件的专有文件格式是()。
A.MongoDB
B.ARFF
C.value
D.key map
正确答案:ARFF
4、数据清洗工作的目的主要是要解决数据的完整性、唯一性、合法性和()。
A.专业性
B.排他性
C.一致性
D.共享性
正确答案:一致性
5、八爪鱼软件的“自定义采集”工作方式下,需要在软件里输入一个()来作为采集的目标。
A.电话号码
B.关键词
C.网页地址
D.用户名
正确答案:网页地址
6、八爪鱼软件的采集规则可以通过文件的形式来导入或者导出,这种文件的后缀名是()。
A.otd
B.jpg
C.png
D.gif
正确答案:otd
7、Excel可以通过“数据有效性”按钮操作来规范数据输入的范围。
A.正确
B.错误
正确答案:A
8、Excel不能导入txt或csv格式的文件。
A.正确
B.错误
正确答案:B
9、八爪鱼软件只能对软件内建了“简易采集”规则的网站采集数据。
A.正确
B.错误
正确答案:B
10、八爪鱼软件进行自定义采集时,需要了解对网页的页面结构。
A.正确
B.错误
正确答案:A
11、我们常用的微软Office套件中的Access数据库软件的数据库文件格式后缀名是()。
A.mdf
B.mdb
C.dbf
D.xls
正确答案:mdb
12、大多数日志文件的后缀名是()。
A.txt
B.csv
C.xml
D.log
正确答案:log
13、本课程重点介绍的weka软件的专有文件格式是()。
A.MongoDB
B.ARFF
C.value
D.key map
正确答案:ARFF
14、数据清洗工作的目的主要是要解决数据的完整性、唯一性、合法性和()。
A.专业性
B.排他性
C.一致性
D.共享性
正确答案:一致性
15、八爪鱼软件的“自定义采集”工作方式下,需要在软件里输入一个()来作为采集的目标。
A.电话号码
B.关键词
C.网页地址
D.用户名
正确答案:网页地址
16、八爪鱼软件的采集规则可以通过文件的形式来导入或者导出,这种文件的后缀名是()。
A.otd
B.jpg
C.png
D.gif
正确答案:otd
17、Excel可以通过“数据有效性”按钮操作来规范数据输入的范围。
A.正确
B.错误
正确答案:A
18、Excel不能导入txt或csv格式的文件。
A.正确
B.错误
正确答案:B
19、八爪鱼软件只能对软件内建了“简易采集”规则的网站采集数据。
A.正确
B.错误
正确答案:B
20、八爪鱼软件进行自定义采集时,需要了解对网页的页面结构。
A.正确
B.错误
正确答案:A
21、我们常用的微软Office套件中的Access数据库软件的数据库文件格式后缀名是()。
A.mdf
B.mdb
C.dbf
D.xls
正确答案:mdb
22、大多数日志文件的后缀名是()。
A.txt
B.csv
C.xml
D.log
正确答案:log
23、本课程重点介绍的weka软件的专有文件格式是()。
A.MongoDB
B.ARFF
C.value
D.key map
正确答案:ARFF
24、数据清洗工作的目的主要是要解决数据的完整性、唯一性、合法性和()。
A.专业性
B.排他性
C.一致性
D.共享性
正确答案:一致性
25、八爪鱼软件的“自定义采集”工作方式下,需要在软件里输入一个()来作为采集的目标。
A.电话号码
B.关键词
C.网页地址
D.用户名
正确答案:网页地址
26、八爪鱼软件的采集规则可以通过文件的形式来导入或者导出,这种文件的后缀名是()。
A.otd
B.jpg
C.png
D.gif
正确答案:otd
27、Excel可以通过“数据有效性”按钮操作来规范数据输入的范围。
A.正确
B.错误
正确答案:A
28、Excel不能导入txt或csv格式的文件。
A.正确
B.错误
正确答案:B
29、八爪鱼软件只能对软件内建了“简易采集”规则的网站采集数据。
A.正确
B.错误
正确答案:B
30、八爪鱼软件进行自定义采集时,需要了解对网页的页面结构。
A.正确
B.错误
正确答案:A
第三章单元测试
1、使用DBSCAN算法对鸢尾花数据集(Iris.arff)进行聚类,将epsilon参数设置为0.2, minPoints参数设置为5,忽略class属性,那么将形成()个簇。
A.1
B.2
C.3
D.4
正确答案:3
2、使用EM算法对天气数据集(weather.numeric.arff)进行聚类,将numClusters设置为4,即簇数为4,其他参数保持默认值,忽略class属性,从结果中可知,下列选项中,()是错误的。
A.模型的最大似然估计值是-7.18
B.这组数据用算法迭代15次
C.第四个簇的先验概率是0.14
D.第四个簇的实例数为4
正确答案:第四个簇的实例数为4
3、使用SimpleKMeans算法对天气数据集(weather.numeric.arff)进行聚类,保持默认参数,即3个簇以及欧氏距离。选择play属性为忽略属性,从结果中可知,下列选项中,()是错误。
A.这组数据用算法迭代四次
B.产生了三个中心点
C.聚合为3个簇,分别有7,3,4个实例
D.平方和误差为8.928
正确答案:这组数据用算法迭代四次
4、使用线性回归(LinearRegression)分类器和用M5P分类器对cpu.arff分别进行分类,由其输出的误差指标可知()。
A.LinearRegression的标准误差比M5P的标准误差小
B.LinearRegression的平均绝对误差比M5P的平均绝对误差小
C.LinearRegression的相对误差比M5P的相对误差小
D.LinearRegression的平均方根误差比M5P的平均方根误差大
正确答案:LinearRegression的平均方根误差比M5P的平均方根误差大
5、删去cpu.arff数据文件中的CACH属性后,使用M5P分类器构建方案,在结果中,到达LM2的实例数有()个。
A.165
B.21
C.23
D.30
正确答案:21
6、根据J48分类器训练weather.nominal.arff所生产的决策树,当outlook=sunny;temperature=cool;humidity =high;windy=TRUE时,分类的结果是()。
A.Yes
B.No
C.没有结果
D.无法分类
正确答案:No
7、根据J48分类器训练iris.arff所生产的决策树,当sepallength=4.4;sepalwidth=3.0;petallength=1.3;petalwidth=0.2时,分类的结果是()。
A.Iris-setosa
B.Iris-versicolor
C.Iris-virginica
D.无法分类
正确答案:Iris-setosa
8、关于Weka离散化说明正确的是()。
A.离散化是将数值属性转换为字符串型属性
B.有监督离散化有两种等宽和等频方法
C.等宽离散化是使实例分布均匀的
D.离散化包括无监督离散化和有监督离散化
正确答案:离散化包括无监督离散化和有监督离散化
9、以下()不是Weka的数据类型。
A.numeric
B.nominal
C.string
D.decimal
正确答案:decimal
10、关于Weka的文件类型描述错误的是()。
A.Weka可以打开文件格式有.arff、.csv、.xlsx
B.Weka处理的数据集类似于关系数据库横行实例,竖行属性
C.arff是ASCII文件,可以用Word等文本编辑器打开查看
D.@relation 定义数据集名称,@data之后呈现实例,每一行就是一个实例
正确答案:Weka可以打开文件格式有.arff、.csv、.xlsx
11、以下属于关联分析的是()。
A.CPU性能预测
B.购物篮分析
C.自动判断鸢尾花类别
D.股票趋势建模
正确答案:购物篮分析
12、大数据时代的到来,使我们无法人为地去发现数据中的奥妙,与此同时,我们更应该注重数据中的相关关系,而不是因果关系。其中,数据之间的相关关系可以通过以下()算法直接挖掘。
A.K-means
B.Bayes Network
C.C4.5
D.Apriori
正确答案:Apriori
13、某超市研究销售纪录数据后发现,买啤酒的人很大概率也会购买尿布,这种属于数据挖掘的()问题。
A.关联规则发现
B.聚类
C.分类
D.自然语言处理
正确答案:关联规则发现
14、在进行自动选择属性时,必须设立两个对象,其中确定使用什么方法为每个属性子集分配一个评估值的对象是下面的()。
A.搜索方法
B.属性评估器
C.元分类器
D.规则挖掘
正确答案:属性评估器
15、以下属于属性空间的搜索方法的是()。
A.GainRatioAttributeEval
B.BestFirst
C.PrincipalComponents
D.SymmetricalUncertAttributeEval
正确答案:BestFirst
16、在weka软件探索者界面中,利用Visualize标签页通过更改各个参数来进行数据集的可视化属性设置后,需要单击以下()按钮,所有更改才会生效。
A.Select Attribute
B.SubSample
C.Update
D.Fast scrolling
正确答案:Update
17、给定关联规则AB,意味着:若A发生,B也会发生。
A.正确
B.错误
正确答案:B
18、支持度是衡量关联规则重要性的一个指标。
A.正确
B.错误
正确答案:A
19、Ranker方法既可以用于单个属性评估器,又可以用于属性子集评估器。
A.正确
B.错误
正确答案:B
20、利用weka软件进行数据可视化时,用户可以选择类别属性对数据点着色,如果类别属性是标称型,则显示为彩色条。
A.正确
B.错误
正确答案:B
21、使用DBSCAN算法对鸢尾花数据集(Iris.arff)进行聚类,将epsilon参数设置为0.2, minPoints参数设置为5,忽略class属性,那么将形成()个簇。
A.1
B.2
C.3
D.4
正确答案:3
22、使用EM算法对天气数据集(weather.numeric.arff)进行聚类,将numClusters设置为4,即簇数为4,其他参数保持默认值,忽略class属性,从结果中可知,下列选项中,()是错误的。
A.模型的最大似然估计值是-7.18
B.这组数据用算法迭代15次
C.第四个簇的先验概率是0.14
D.第四个簇的实例数为4
正确答案:第四个簇的实例数为4
23、使用SimpleKMeans算法对天气数据集(weather.numeric.arff)进行聚类,保持默认参数,即3个簇以及欧氏距离。选择play属性为忽略属性,从结果中可知,下列选项中,()是错误。
A.这组数据用算法迭代四次
B.产生了三个中心点
C.聚合为3个簇,分别有7,3,4个实例
D.平方和误差为8.928
正确答案:这组数据用算法迭代四次
24、使用线性回归(LinearRegression)分类器和用M5P分类器对cpu.arff分别进行分类,由其输出的误差指标可知()。
A.LinearRegression的标准误差比M5P的标准误差小
B.LinearRegression的平均绝对误差比M5P的平均绝对误差小
C.LinearRegression的相对误差比M5P的相对误差小
D.LinearRegression的平均方根误差比M5P的平均方根误差大
正确答案:LinearRegression的平均方根误差比M5P的平均方根误差大
25、删去cpu.arff数据文件中的CACH属性后,使用M5P分类器构建方案,在结果中,到达LM2的实例数有()个。
A.165
B.21
C.23
D.30
正确答案:21
26、根据J48分类器训练weather.nominal.arff所生产的决策树,当outlook=sunny;temperature=cool;humidity =high;windy=TRUE时,分类的结果是()。
A.Yes
B.No
C.没有结果
D.无法分类
正确答案:No
27、根据J48分类器训练iris.arff所生产的决策树,当sepallength=4.4;sepalwidth=3.0;petallength=1.3;petalwidth=0.2时,分类的结果是()。
A.Iris-setosa
B.Iris-versicolor
C.Iris-virginica
D.无法分类
正确答案:Iris-setosa
28、关于Weka离散化说明正确的是()。
A.离散化是将数值属性转换为字符串型属性
B.有监督离散化有两种等宽和等频方法
C.等宽离散化是使实例分布均匀的
D.离散化包括无监督离散化和有监督离散化
正确答案:离散化包括无监督离散化和有监督离散化
29、以下()不是Weka的数据类型。
A.numeric
B.nominal
C.string
D.decimal
正确答案:decimal
30、关于Weka的文件类型描述错误的是()。
A.Weka可以打开文件格式有.arff、.csv、.xlsx
B.Weka处理的数据集类似于关系数据库横行实例,竖行属性
C.arff是ASCII文件,可以用Word等文本编辑器打开查看
D.@relation 定义数据集名称,@data之后呈现实例,每一行就是一个实例
正确答案:Weka可以打开文件格式有.arff、.csv、.xlsx
31、以下属于关联分析的是()。
A.CPU性能预测
B.购物篮分析
C.自动判断鸢尾花类别
D.股票趋势建模
正确答案:购物篮分析
32、大数据时代的到来,使我们无法人为地去发现数据中的奥妙,与此同时,我们更应该注重数据中的相关关系,而不是因果关系。其中,数据之间的相关关系可以通过以下()算法直接挖掘。
A.K-means
B.Bayes Network
C.C4.5
D.Apriori
正确答案:Apriori
33、某超市研究销售纪录数据后发现,买啤酒的人很大概率也会购买尿布,这种属于数据挖掘的()问题。
A.关联规则发现
B.聚类
C.分类
D.自然语言处理
正确答案:关联规则发现
34、在进行自动选择属性时,必须设立两个对象,其中确定使用什么方法为每个属性子集分配一个评估值的对象是下面的()。
A.搜索方法
B.属性评估器
C.元分类器
D.规则挖掘
正确答案:属性评估器
35、以下属于属性空间的搜索方法的是()。
A.GainRatioAttributeEval
B.BestFirst
C.PrincipalComponents
D.SymmetricalUncertAttributeEval
正确答案:BestFirst
36、在weka软件探索者界面中,利用Visualize标签页通过更改各个参数来进行数据集的可视化属性设置后,需要单击以下()按钮,所有更改才会生效。
A.Select Attribute
B.SubSample
C.Update
D.Fast scrolling
正确答案:Update
37、给定关联规则AB,意味着:若A发生,B也会发生。
A.正确
B.错误
正确答案:B
38、支持度是衡量关联规则重要性的一个指标。
A.正确
B.错误
正确答案:A
39、Ranker方法既可以用于单个属性评估器,又可以用于属性子集评估器。
A.正确
B.错误
正确答案:B
40、利用weka软件进行数据可视化时,用户可以选择类别属性对数据点着色,如果类别属性是标称型,则显示为彩色条。
A.正确
B.错误
正确答案:B
41、使用DBSCAN算法对鸢尾花数据集(Iris.arff)进行聚类,将epsilon参数设置为0.2, minPoints参数设置为5,忽略class属性,那么将形成()个簇。
A.1
B.2
C.3
D.4
正确答案:3
42、使用EM算法对天气数据集(weather.numeric.arff)进行聚类,将numClusters设置为4,即簇数为4,其他参数保持默认值,忽略class属性,从结果中可知,下列选项中,()是错误的。
A.模型的最大似然估计值是-7.18
B.这组数据用算法迭代15次
C.第四个簇的先验概率是0.14
D.第四个簇的实例数为4
正确答案:第四个簇的实例数为4
43、使用SimpleKMeans算法对天气数据集(weather.numeric.arff)进行聚类,保持默认参数,即3个簇以及欧氏距离。选择play属性为忽略属性,从结果中可知,下列选项中,()是错误。
A.这组数据用算法迭代四次
B.产生了三个中心点
C.聚合为3个簇,分别有7,3,4个实例
D.平方和误差为8.928
正确答案:这组数据用算法迭代四次
44、使用线性回归(LinearRegression)分类器和用M5P分类器对cpu.arff分别进行分类,由其输出的误差指标可知()。
A.LinearRegression的标准误差比M5P的标准误差小
B.LinearRegression的平均绝对误差比M5P的平均绝对误差小
C.LinearRegression的相对误差比M5P的相对误差小
D.LinearRegression的平均方根误差比M5P的平均方根误差大
正确答案:LinearRegression的平均方根误差比M5P的平均方根误差大
45、删去cpu.arff数据文件中的CACH属性后,使用M5P分类器构建方案,在结果中,到达LM2的实例数有()个。
A.165
B.21
C.23
D.30
正确答案:21
46、根据J48分类器训练weather.nominal.arff所生产的决策树,当outlook=sunny;temperature=cool;humidity =high;windy=TRUE时,分类的结果是()。
A.Yes
B.No
C.没有结果
D.无法分类
正确答案:No
47、根据J48分类器训练iris.arff所生产的决策树,当sepallength=4.4;sepalwidth=3.0;petallength=1.3;petalwidth=0.2时,分类的结果是()。
A.Iris-setosa
B.Iris-versicolor
C.Iris-virginica
D.无法分类
正确答案:Iris-setosa
48、关于Weka离散化说明正确的是()。
A.离散化是将数值属性转换为字符串型属性
B.有监督离散化有两种等宽和等频方法
C.等宽离散化是使实例分布均匀的
D.离散化包括无监督离散化和有监督离散化
正确答案:离散化包括无监督离散化和有监督离散化
49、以下()不是Weka的数据类型。
A.numeric
B.nominal
C.string
D.decimal
正确答案:decimal
50、关于Weka的文件类型描述错误的是()。
A.Weka可以打开文件格式有.arff、.csv、.xlsx
B.Weka处理的数据集类似于关系数据库横行实例,竖行属性
C.arff是ASCII文件,可以用Word等文本编辑器打开查看
D.@relation 定义数据集名称,@data之后呈现实例,每一行就是一个实例
正确答案:Weka可以打开文件格式有.arff、.csv、.xlsx
51、以下属于关联分析的是()。
A.CPU性能预测
B.购物篮分析
C.自动判断鸢尾花类别
D.股票趋势建模
正确答案:购物篮分析
52、大数据时代的到来,使我们无法人为地去发现数据中的奥妙,与此同时,我们更应该注重数据中的相关关系,而不是因果关系。其中,数据之间的相关关系可以通过以下()算法直接挖掘。
A.K-means
B.Bayes Network
C.C4.5
D.Apriori
正确答案:Apriori
53、某超市研究销售纪录数据后发现,买啤酒的人很大概率也会购买尿布,这种属于数据挖掘的()问题。
A.关联规则发现
B.聚类
C.分类
D.自然语言处理
正确答案:关联规则发现
54、在进行自动选择属性时,必须设立两个对象,其中确定使用什么方法为每个属性子集分配一个评估值的对象是下面的()。
A.搜索方法
B.属性评估器
C.元分类器
D.规则挖掘
正确答案:属性评估器
55、以下属于属性空间的搜索方法的是()。
A.GainRatioAttributeEval
B.BestFirst
C.PrincipalComponents
D.SymmetricalUncertAttributeEval
正确答案:BestFirst
56、在weka软件探索者界面中,利用Visualize标签页通过更改各个参数来进行数据集的可视化属性设置后,需要单击以下()按钮,所有更改才会生效。
A.Select Attribute
B.SubSample
C.Update
D.Fast scrolling
正确答案:Update
57、给定关联规则AB,意味着:若A发生,B也会发生。
A.正确
B.错误
正确答案:B
58、支持度是衡量关联规则重要性的一个指标。
A.正确
B.错误
正确答案:A
59、Ranker方法既可以用于单个属性评估器,又可以用于属性子集评估器。
A.正确
B.错误
正确答案:B
60、利用weka软件进行数据可视化时,用户可以选择类别属性对数据点着色,如果类别属性是标称型,则显示为彩色条。
A.正确
B.错误
正确答案:B
第四章单元测试
1、贝叶斯网络中的节点代表()。
A.变量
B.随机过程
C.随机变量
D.随机函数
正确答案:随机变量
2、贝叶斯网络中,节点需给出概率分布描述,对于离散型随机变量而言,可以用()的形式表示。
A.条件概率密度函数
B.正态分布
C.条件概率表
D.均匀分布
正确答案:条件概率表
3、贝叶斯网络中节点之间的边代表()。
A.随机关系
B.概率因果
C.组合关系
D.随机结果
正确答案:随机关系
4、贝叶斯网络保存的文件格式是()。
A.XML BIF
B.DOCX
C.TXT
D.XLS
正确答案:XML BIF
5、下面()不是反向传播神经网络的结构。
A.输入层
B.隐含层
C.计算层
D.输出层
正确答案:计算层
6、神经网络中的节点代表()。
A.激励变量
B.激励函数
C.随机变量
D.随机函数
正确答案:激励函数
7、下列()不是常见的激励函数。
A.线性函数
B.Sigmoid函数
C.阈值函数
D.正弦函数
正确答案:正弦函数
8、在贝叶斯网络编辑界面时,如果节点的名称没法完全显示,需要从()菜单项进行调整。
A.Tools|SetData
B.View|Zoom Out
C.View|Zoom In
D.Tools|Layout
正确答案:Tools|Layout
9、WEKA中选择神经网络分类器操作时,应该选择()。
A.rules条目下的PART
B.functions条目下的SGD分类器
C.functions条目下的MultilayerPerceptron分类器
D.默认的分类器
正确答案:functions条目下的MultilayerPerceptron分类器
10、下面关于Package Manager安装后的目录说明不正确的是()。
A.doc子目录存放API文档
B.lib子目录存放包所需要的说明文件
C.sample-data子目录存放数据集文件
D.src子目录存放源代码文件
正确答案:lib子目录存放包所需要的说明文件
11、贝叶斯网络中的节点代表()。
A.变量
B.随机过程
C.随机变量
D.随机函数
正确答案:随机变量
12、贝叶斯网络中,节点需给出概率分布描述,对于离散型随机变量而言,可以用()的形式表示。
A.条件概率密度函数
B.正态分布
C.条件概率表
D.均匀分布
正确答案:条件概率表
13、贝叶斯网络中节点之间的边代表()。
A.随机关系
B.概率因果
C.组合关系
D.随机结果
正确答案:随机关系
14、贝叶斯网络保存的文件格式是()。
A.XML BIF
B.DOCX
C.TXT
D.XLS
正确答案:XML BIF
15、下面()不是反向传播神经网络的结构。
A.输入层
B.隐含层
C.计算层
D.输出层
正确答案:计算层
16、神经网络中的节点代表()。
A.激励变量
B.激励函数
C.随机变量
D.随机函数
正确答案:激励函数
17、下列()不是常见的激励函数。
A.线性函数
B.Sigmoid函数
C.阈值函数
D.正弦函数
正确答案:正弦函数
18、在贝叶斯网络编辑界面时,如果节点的名称没法完全显示,需要从()菜单项进行调整。
A.Tools|SetData
B.View|Zoom Out
C.View|Zoom In
D.Tools|Layout
正确答案:Tools|Layout
19、WEKA中选择神经网络分类器操作时,应该选择()。
A.rules条目下的PART
B.functions条目下的SGD分类器
C.functions条目下的MultilayerPerceptron分类器
D.默认的分类器
正确答案:functions条目下的MultilayerPerceptron分类器
20、下面关于Package Manager安装后的目录说明不正确的是()。
A.doc子目录存放API文档
B.lib子目录存放包所需要的说明文件
C.sample-data子目录存放数据集文件
D.src子目录存放源代码文件
正确答案:lib子目录存放包所需要的说明文件
21、贝叶斯网络中的节点代表()。
A.变量
B.随机过程
C.随机变量
D.随机函数
正确答案:随机变量
22、贝叶斯网络中,节点需给出概率分布描述,对于离散型随机变量而言,可以用()的形式表示。
A.条件概率密度函数
B.正态分布
C.条件概率表
D.均匀分布
正确答案:条件概率表
23、贝叶斯网络中节点之间的边代表()。
A.随机关系
B.概率因果
C.组合关系
D.随机结果
正确答案:随机关系
24、贝叶斯网络保存的文件格式是()。
A.XML BIF
B.DOCX
C.TXT
D.XLS
正确答案:XML BIF
25、下面()不是反向传播神经网络的结构。
A.输入层
B.隐含层
C.计算层
D.输出层
正确答案:计算层
26、神经网络中的节点代表()。
A.激励变量
B.激励函数
C.随机变量
D.随机函数
正确答案:激励函数
27、下列()不是常见的激励函数。
A.线性函数
B.Sigmoid函数
C.阈值函数
D.正弦函数
正确答案:正弦函数
28、在贝叶斯网络编辑界面时,如果节点的名称没法完全显示,需要从()菜单项进行调整。
A.Tools|SetData
B.View|Zoom Out
C.View|Zoom In
D.Tools|Layout
正确答案:Tools|Layout
29、WEKA中选择神经网络分类器操作时,应该选择()。
A.rules条目下的PART
B.functions条目下的SGD分类器
C.functions条目下的MultilayerPerceptron分类器
D.默认的分类器
正确答案:functions条目下的MultilayerPerceptron分类器
30、下面关于Package Manager安装后的目录说明不正确的是()。
A.doc子目录存放API文档
B.lib子目录存放包所需要的说明文件
C.sample-data子目录存放数据集文件
D.src子目录存放源代码文件
正确答案:lib子目录存放包所需要的说明文件
第五章单元测试
1、Tableau是一款定位于数据可视化敏捷开发和实现()展现工具。Tableau 连续第 6 年在 Gartner 分析和商业智能魔力象限中蝉联领导者殊荣。
A.商务智能
B.商业行为
C.商务计算
D.商业统计
正确答案:商务智能
2、以下()不是Tableau的数据类型?
A.Boolean
B.Date
C.
String
D.Decimal
正确答案:Decimal
3、Tableau可以用来实现交互的、()的分析和仪表板应用,从而帮助我们快速地认识和理解数据。
A.
连续性
B.离散性
C.智能化
D.可视化
正确答案:可视化
4、下列说法错误的是()。
A.Tableau通过内存数据引擎,可以直接查询外部数据库同时动态的从数据仓库抽取实时数据,极大的提高了数据访问和查询效率
B.用户仅需要通过轻点鼠标和简单拖放就可以迅速创建出智能、精美、直观和具有强交互性的报表和仪表盘
C.Tableau允许从多个数据源访问数据,包括带分隔符的文本文件、Excel文件、SQL数据库、Oracle数据库和多维数据库等
D.Tableau不提供应用编程接口
正确答案:Tableau不提供应用编程接口
5、度量往往是()字段,度量是我们的指标。度量常常是连续的,连续的字段在图表中形成轴.将其拖放到功能区时,Tableau默认会进行()。
A.数值,聚合运算
B.数值,混合运算
C.分类,聚合运算
D.分类,混合运算
正确答案:数值,聚合运算
6、关于数据分层描述错误的是()。
A.数据分层可以实现向上钻取
B.数据分层可以实现向下钻取
C.数据分层的层级结构由数据维度的上下顺序决定
D.数据分层的层次结构可以手工调整
正确答案:数据分层可以实现向上钻取
7、以下不属于集的创建方式的是()。
A.[常规]创建
B.[条件]创建
C.[顶部]创建
D.[分组]创建
正确答案:[分组]创建
8、Tableau右边数据目录栏中,不能单击右键创建参数的纬度是()。
A.纬度
B.度量
C.集
D.参数
正确答案:集
9、以下不是创建计算字段时的运算逻辑的是()。
A.数字
B.日期
C.用户
D.表结构
正确答案:表结构
10、仪表板版面大小设计选项,()不属于大小设计选项。
A.固定大小
B.自动
C.范围
D.自定义
正确答案:自定义
11、Tableau是一款定位于数据可视化敏捷开发和实现()展现工具。Tableau 连续第 6 年在 Gartner 分析和商业智能魔力象限中蝉联领导者殊荣。
A.商务智能
B.商业行为
C.商务计算
D.商业统计
正确答案:商务智能
12、以下()不是Tableau的数据类型?
A.Boolean
B.Date
C.
String
D.Decimal
正确答案:Decimal
13、Tableau可以用来实现交互的、()的分析和仪表板应用,从而帮助我们快速地认识和理解数据。
A.
连续性
B.离散性
C.智能化
D.可视化
正确答案:可视化
14、下列说法错误的是()。
A.Tableau通过内存数据引擎,可以直接查询外部数据库同时动态的从数据仓库抽取实时数据,极大的提高了数据访问和查询效率
B.用户仅需要通过轻点鼠标和简单拖放就可以迅速创建出智能、精美、直观和具有强交互性的报表和仪表盘
C.Tableau允许从多个数据源访问数据,包括带分隔符的文本文件、Excel文件、SQL数据库、Oracle数据库和多维数据库等
D.Tableau不提供应用编程接口
正确答案:Tableau不提供应用编程接口
15、度量往往是()字段,度量是我们的指标。度量常常是连续的,连续的字段在图表中形成轴.将其拖放到功能区时,Tableau默认会进行()。
A.数值,聚合运算
B.数值,混合运算
C.分类,聚合运算
D.分类,混合运算
正确答案:数值,聚合运算
16、关于数据分层描述错误的是()。
A.数据分层可以实现向上钻取
B.数据分层可以实现向下钻取
C.数据分层的层级结构由数据维度的上下顺序决定
D.数据分层的层次结构可以手工调整
正确答案:数据分层可以实现向上钻取
17、以下不属于集的创建方式的是()。
A.[常规]创建
B.[条件]创建
C.[顶部]创建
D.[分组]创建
正确答案:[分组]创建
18、Tableau右边数据目录栏中,不能单击右键创建参数的纬度是()。
A.纬度
B.度量
C.集
D.参数
正确答案:集
19、以下不是创建计算字段时的运算逻辑的是()。
A.数字
B.日期
C.用户
D.表结构
正确答案:表结构
20、仪表板版面大小设计选项,()不属于大小设计选项。
A.固定大小
B.自动
C.范围
D.自定义
正确答案:自定义
21、Tableau是一款定位于数据可视化敏捷开发和实现()展现工具。Tableau 连续第 6 年在 Gartner 分析和商业智能魔力象限中蝉联领导者殊荣。
A.商务智能
B.商业行为
C.商务计算
D.商业统计
正确答案:商务智能
22、以下()不是Tableau的数据类型?
A.Boolean
B.Date
C.
String
D.Decimal
正确答案:Decimal
23、Tableau可以用来实现交互的、()的分析和仪表板应用,从而帮助我们快速地认识和理解数据。
A.
连续性
B.离散性
C.智能化
D.可视化
正确答案:可视化
24、下列说法错误的是()。
A.Tableau通过内存数据引擎,可以直接查询外部数据库同时动态的从数据仓库抽取实时数据,极大的提高了数据访问和查询效率
B.用户仅需要通过轻点鼠标和简单拖放就可以迅速创建出智能、精美、直观和具有强交互性的报表和仪表盘
C.Tableau允许从多个数据源访问数据,包括带分隔符的文本文件、Excel文件、SQL数据库、Oracle数据库和多维数据库等
D.Tableau不提供应用编程接口
正确答案:Tableau不提供应用编程接口
25、度量往往是()字段,度量是我们的指标。度量常常是连续的,连续的字段在图表中形成轴.将其拖放到功能区时,Tableau默认会进行()。
A.数值,聚合运算
B.数值,混合运算
C.分类,聚合运算
D.分类,混合运算
正确答案:数值,聚合运算
26、关于数据分层描述错误的是()。
A.数据分层可以实现向上钻取
B.数据分层可以实现向下钻取
C.数据分层的层级结构由数据维度的上下顺序决定
D.数据分层的层次结构可以手工调整
正确答案:数据分层可以实现向上钻取
27、以下不属于集的创建方式的是()。
A.[常规]创建
B.[条件]创建
C.[顶部]创建
D.[分组]创建
正确答案:[分组]创建
28、Tableau右边数据目录栏中,不能单击右键创建参数的纬度是()。
A.纬度
B.度量
C.集
D.参数
正确答案:集
29、以下不是创建计算字段时的运算逻辑的是()。
A.数字
B.日期
C.用户
D.表结构
正确答案:表结构
30、仪表板版面大小设计选项,()不属于大小设计选项。
A.固定大小
B.自动
C.范围
D.自定义
正确答案:自定义
第六章单元测试
1、Logistic函数的定义域是()。
A.(-INF, +INF)
B.[0, 1]
C.(0, +INF)
D.(-INF, 1)
正确答案:(-INF, +INF)
2、下列叙述错误的是()。
A.逻辑回归是一种监督机器学习算法
B.逻辑回归主要用于回归分析
C.逻辑回归采用Sigmoid函数对样本数据进行拟合,以构建回归模型
D.逻辑回归预测事件发生的概率并分析导致事件发生的因素
正确答案:逻辑回归主要用于回归分析
3、使用IBk分类器和SMO分类器对vote.arff分别进行分类,由其输出的结果可知()。
A.IBk正确分类百分比比SMO大
B.IBk对republican的分类正确率比SMO大
C.SMO对democrat的分类正确率比IBk小
D.SMO对democrat和republican的分类正确率都比IBk大
正确答案:SMO对democrat和republican的分类正确率都比IBk大
4、
A.0或1
B.0或-1
C.1或-1
D.true或false
正确答案:1或-1
5、以下描述错误的是()。
A.SVM对噪声不具备鲁棒性
B.SVM寻找具有最小边缘的超平面,因此经常被称为最小边缘分类器
C.k-最近邻算法(K-NN)是一种消极学习器
D.聚类分析可以看作是一种非监督的分类
正确答案:SVM寻找具有最小边缘的超平面,因此经常被称为最小边缘分类器
6、线性支持向量机的最大化间隔正确的描述是()。
A.
B.
C.
D.
正确答案:
7、以下计算距离的公式中,计算欧氏距离的是()。
A.
B.
C.
D.
正确答案:
8、Logistic函数的定义域是()。
A.(-INF, +INF)
B.[0, 1]
C.(0, +INF)
D.(-INF, 1)
正确答案:(-INF, +INF)
9、下列叙述错误的是()。
A.逻辑回归是一种监督机器学习算法
B.逻辑回归主要用于回归分析
C.逻辑回归采用Sigmoid函数对样本数据进行拟合,以构建回归模型
D.逻辑回归预测事件发生的概率并分析导致事件发生的因素
正确答案:逻辑回归主要用于回归分析
10、使用IBk分类器和SMO分类器对vote.arff分别进行分类,由其输出的结果可知()。
A.IBk正确分类百分比比SMO大
B.IBk对republican的分类正确率比SMO大
C.SMO对democrat的分类正确率比IBk小
D.SMO对democrat和republican的分类正确率都比IBk大
正确答案:SMO对democrat和republican的分类正确率都比IBk大
11、
A.0或1
B.0或-1
C.1或-1
D.true或false
正确答案:1或-1
12、以下描述错误的是()。
A.SVM对噪声不具备鲁棒性
B.SVM寻找具有最小边缘的超平面,因此经常被称为最小边缘分类器
C.k-最近邻算法(K-NN)是一种消极学习器
D.聚类分析可以看作是一种非监督的分类
正确答案:SVM寻找具有最小边缘的超平面,因此经常被称为最小边缘分类器
13、线性支持向量机的最大化间隔正确的描述是()。
A.
B.
C.
D.
正确答案:
14、以下计算距离的公式中,计算欧氏距离的是()。
A.
B.
C.
D.
正确答案:
15、Logistic函数的定义域是()。
A.(-INF, +INF)
B.[0, 1]
C.(0, +INF)
D.(-INF, 1)
正确答案:(-INF, +INF)
16、下列叙述错误的是()。
A.逻辑回归是一种监督机器学习算法
B.逻辑回归主要用于回归分析
C.逻辑回归采用Sigmoid函数对样本数据进行拟合,以构建回归模型
D.逻辑回归预测事件发生的概率并分析导致事件发生的因素
正确答案:逻辑回归主要用于回归分析
17、使用IBk分类器和SMO分类器对vote.arff分别进行分类,由其输出的结果可知()。
A.IBk正确分类百分比比SMO大
B.IBk对republican的分类正确率比SMO大
C.SMO对democrat的分类正确率比IBk小
D.SMO对democrat和republican的分类正确率都比IBk大
正确答案:SMO对democrat和republican的分类正确率都比IBk大
18、
A.0或1
B.0或-1
C.1或-1
D.true或false
正确答案:1或-1
19、以下描述错误的是()。
A.SVM对噪声不具备鲁棒性
B.SVM寻找具有最小边缘的超平面,因此经常被称为最小边缘分类器
C.k-最近邻算法(K-NN)是一种消极学习器
D.聚类分析可以看作是一种非监督的分类
正确答案:SVM寻找具有最小边缘的超平面,因此经常被称为最小边缘分类器
20、线性支持向量机的最大化间隔正确的描述是()。
A.
B.
C.
D.
正确答案:
21、以下计算距离的公式中,计算欧氏距离的是()。
A.
B.
C.
D.
正确答案:
第七章单元测试
1、以下数据和信息的说法,不正确的是()。
A.信息是客观世界各种事物特征的反映
B.数据对用户来说是有价值的
C.数据的形式是多样化的
D.凡是可以电子化记录下来的都是数据
正确答案:数据对用户来说是有价值的
2、以下关于数据分析的方法,正确的是()。
A.数据分析是信息到数据的转换过程
B.分析是一个过程,分析的对象是信息
C.所有的分析都是要从“过程”出发,没有结论的数字罗列并不是分析
D.数据分析的目的就是解决我们现实中的某个问题
正确答案:数据分析的目的就是解决我们现实中的某个问题
3、以下不属于数据分析的作用的是()。
A.数据分析有助于增加营销开支
B.数据分析有助于企业分析目标客户
C.数据分析有助于企业绩效分析与管理
D.数据分析有助于优化运营前线
正确答案:数据分析有助于增加营销开支
4、以下不属于问题的有效性检验的是()。
A.复杂性检验
B.必要性检验
C.有用性检验
D.可行性检验
正确答案:必要性检验
5、图a到图b的转变,属于数据分析思维中的哪一种思维()。图a
图b
A.对照
B.拆分
C.降维
D.增维
正确答案:对照
6、当我们当前的维度不能很好地解释我们的问题时,我们就需要对数据做一个运算,增加多一个指标。这属于以下哪种思维方式()。
A.对照
B.拆分
C.降维
D.增维
正确答案:增维
7、对()的理解是数据分析的前提。
A.数据
B.信息
C.业务
D.结果
正确答案:业务
8、以下不属于初级数据分析方法的是()。
A.回归分析法
B.平均分析法
C.对比分析法
D.交叉分析法
正确答案:回归分析法
9、对多种影响因素按其重要程度进行一定组合,先按第一组合选择出较大范围目标对象,再按第二组合对第一组合筛选出来的对象进一步缩小范围,以此类推,得出最终目标对象。该描述是以下哪种数据分析方法的思想()。
A.回归分析法
B.平均分析法
C.对比分析法
D.层层筛选法
正确答案:层层筛选法
10、一个好的统计图需满足的标准,不包括以下()。
A.准确
B.有效
C.简洁
D.清楚
正确答案:清楚
11、一般情况下在作图时先不添加()区。
A.坐标轴
B.绘图区
C.标题区
D.图例区
正确答案:标题区
12、连续性单变量图不包括()。
A.直方图
B.箱线图
C.P-P图
D.条形图
正确答案:条形图
13、两个定性变量可选择的作图不包括()。
A.复式条形图
B.散点图
C.堆叠条形图
D.马赛克图
正确答案:散点图
14、堆叠条形图和马赛克图可以在图形属性中直接转换。
A.正确
B.错误
正确答案:A
15、定性变量作定量变量的相应图形也是有意义的。
A.正确
B.错误
正确答案:B
16、多维度数据图形一般还是以二维的形式展示,只通过形状、颜色等要素扩展维度信息。
A.正确
B.错误
正确答案:A
17、制作统计图有两个基本要求:一是正确,二是简洁。
A.正确
B.错误
正确答案:A
18、一般情况下在作图时先不添加()区。
A.坐标轴
B.绘图区
C.标题区
D.图例区
正确答案:标题区
19、连续性单变量图不包括()。
A.直方图
B.箱线图
C.P-P图
D.条形图
正确答案:条形图
20、两个定性变量可选择的作图不包括()。
A.复式条形图
B.散点图
C.堆叠条形图
D.马赛克图
正确答案:散点图
21、堆叠条形图和马赛克图可以在图形属性中直接转换。
A.正确
B.错误
正确答案:A
22、定性变量作定量变量的相应图形也是有意义的。
A.正确
B.错误
正确答案:B
23、多维度数据图形一般还是以二维的形式展示,只通过形状、颜色等要素扩展维度信息。
A.正确
B.错误
正确答案:A
24、制作统计图有两个基本要求:一是正确,二是简洁。
A.正确
B.错误
正确答案:A